Kappa Architecture Explained
Data & AI Pipelines diagram · made in Skemio
What it shows
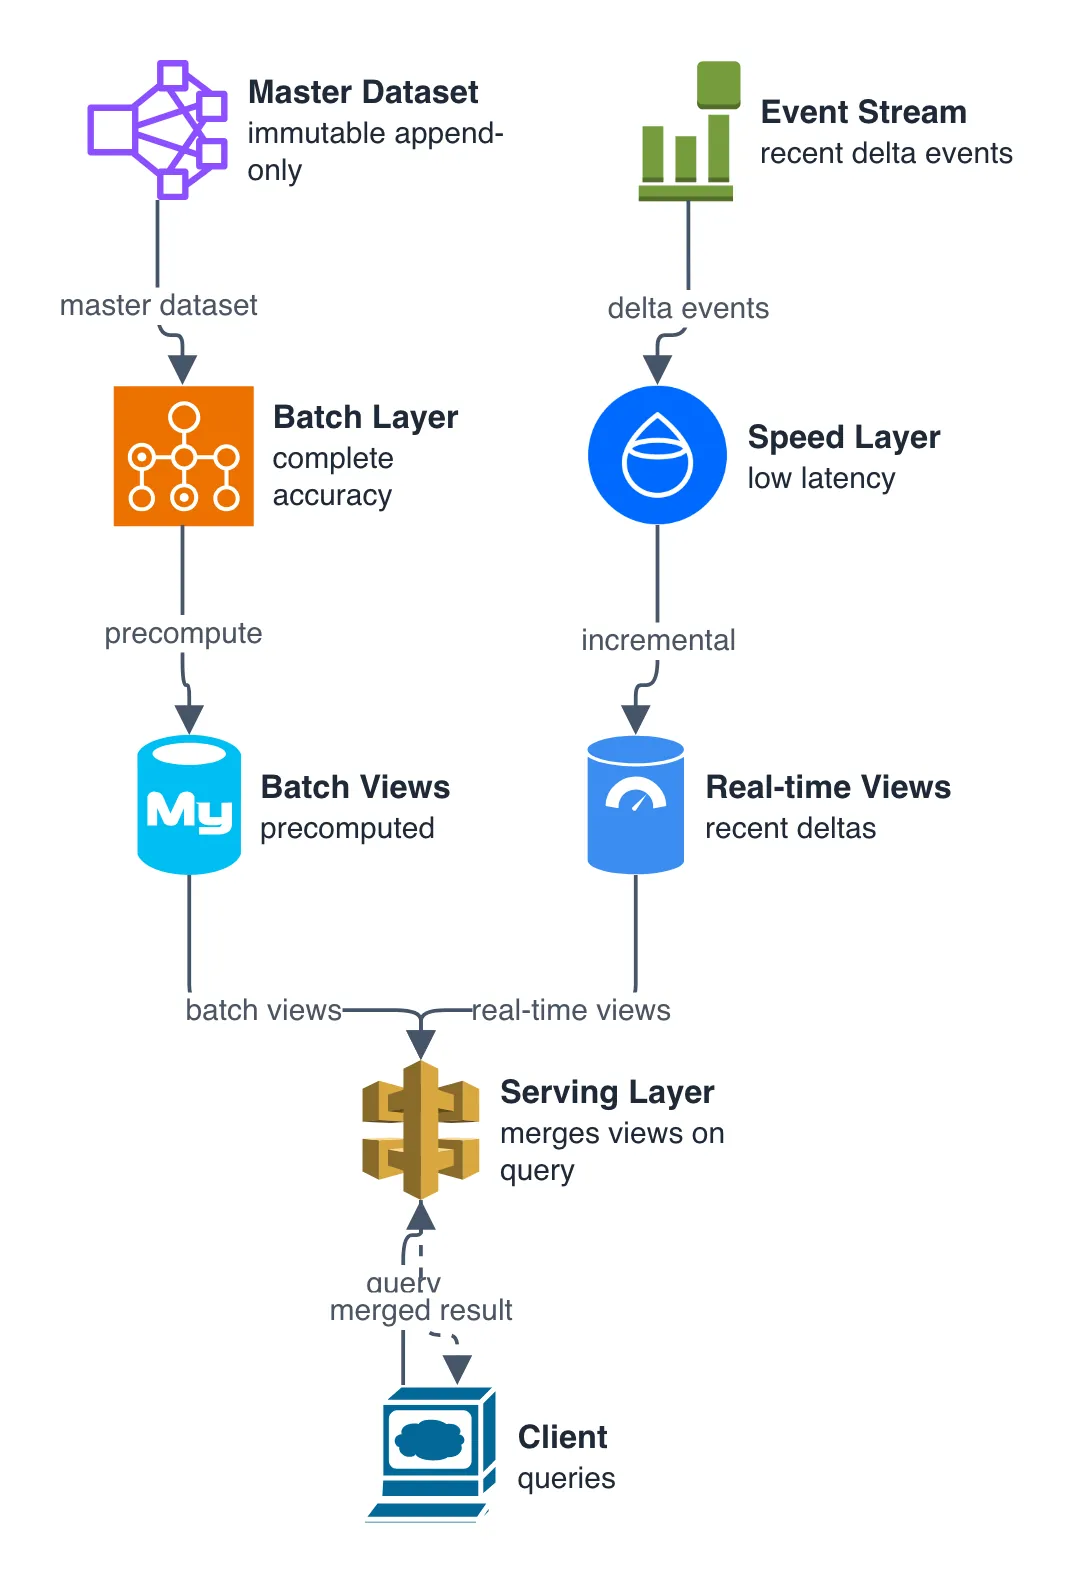
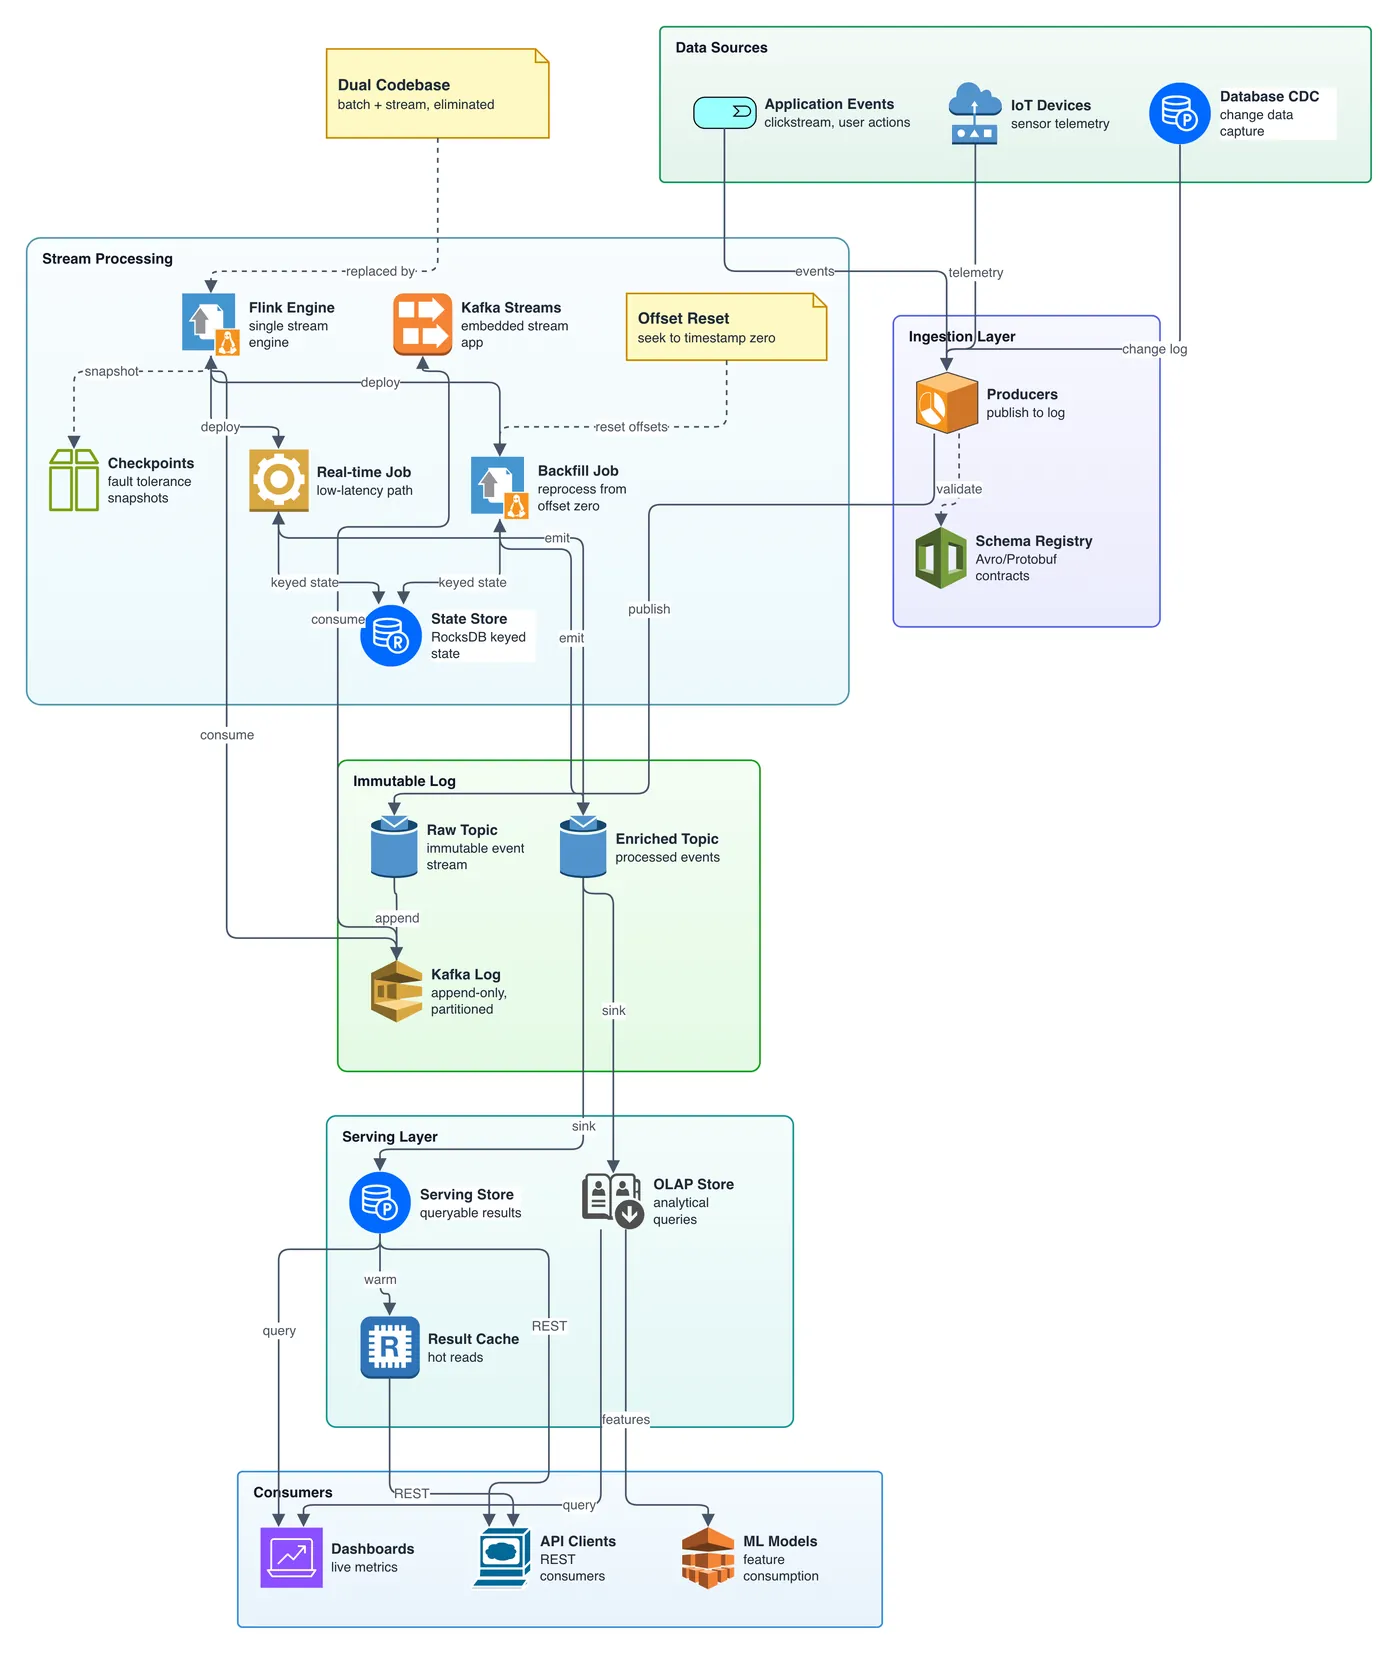
- Eliminates the dual codebase problem by treating everything as a stream.
- Reprocessing history simply means resetting consumer offsets to timestamp zero.
- A single stream engine (Flink/Kafka Streams) handles real-time and backfills.
The takeaway
Kappa treats batch processing as a subset of streaming: all data is an infinite, replayable log.
- #KappaArchitecture
- #DataEngineering
- #ApacheFlink
- #ApacheKafka
- #SystemDesign