Basic RAG Retrieval Pipeline
Data & AI Pipelines diagram · made in Skemio
What it shows
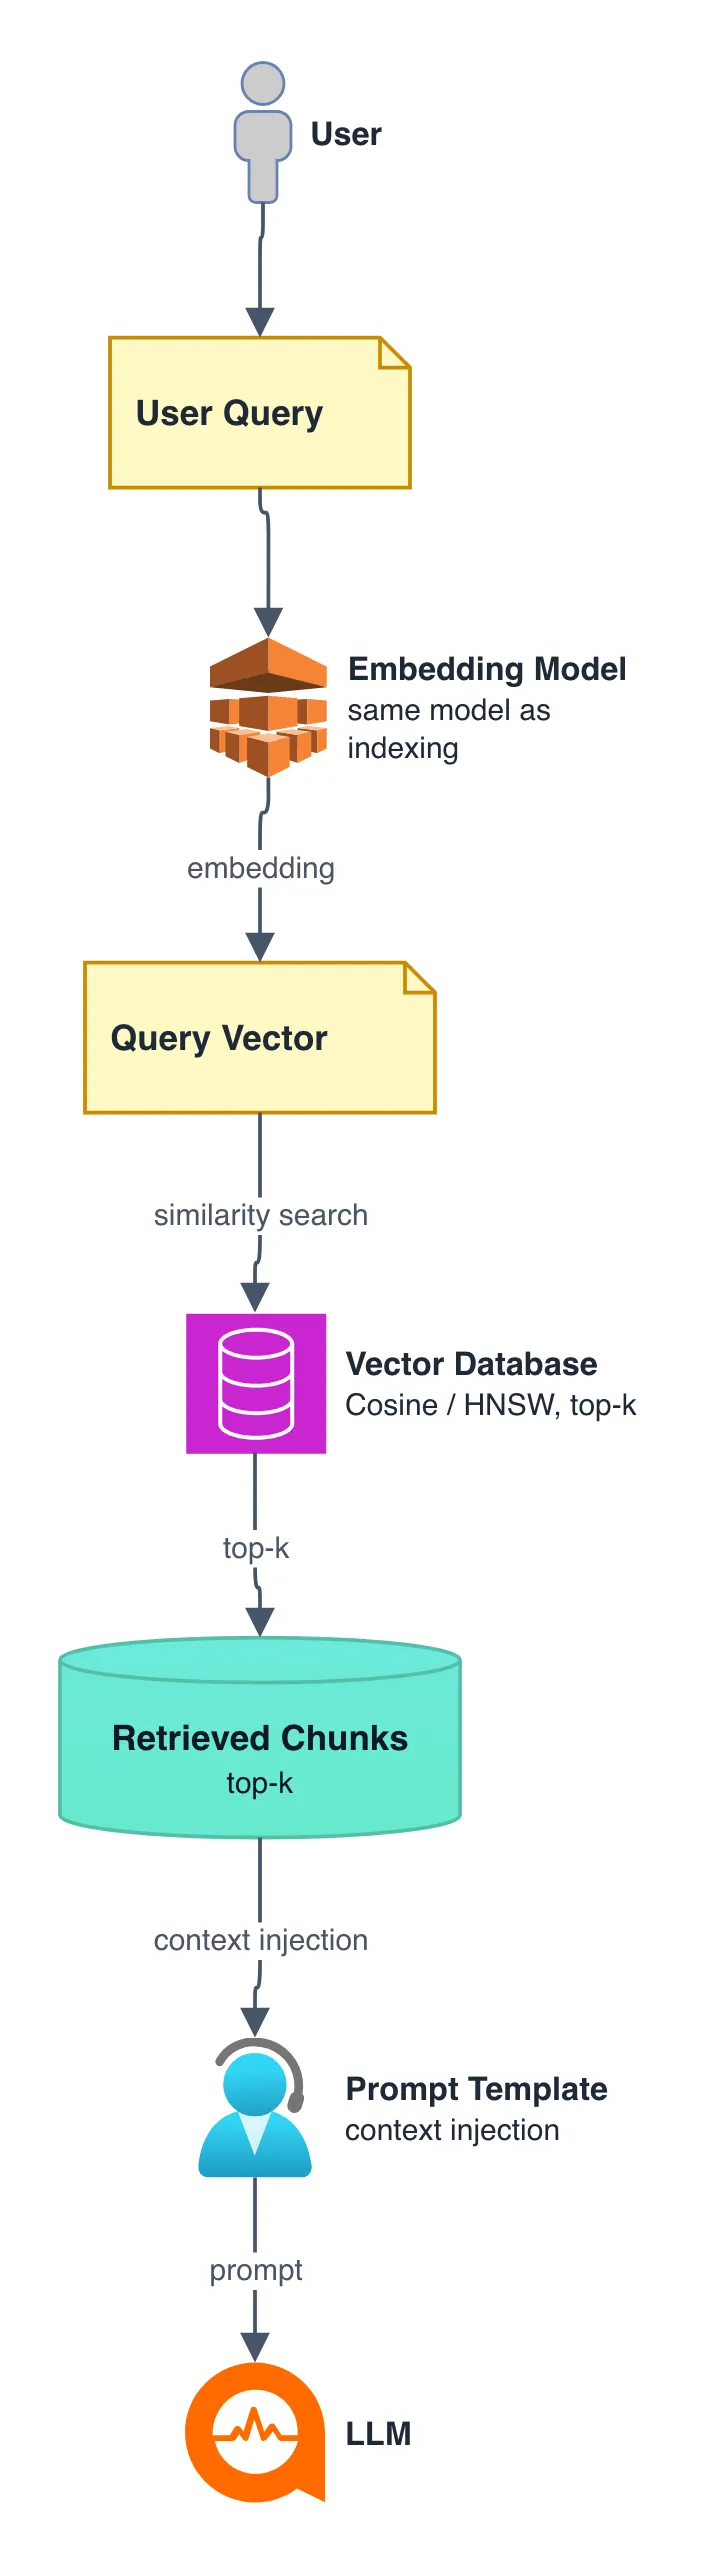
- User query is converted into a vector embedding using the same model.
- Vector database runs similarity search (e.g., Cosine/HNSW) for top-k.
- Retrieved chunks are injected into a prompt template passed to the LLM.
The takeaway
RAG grounds generative models by retrieving external domain knowledge at runtime.
- #RAG
- #GenerativeAI
- #LLM
- #VectorSearch
- #MachineLearning
- #AIArchitecture