Micro-Batching vs Native Streaming
Data & AI Pipelines diagram · made in Skemio
What it shows
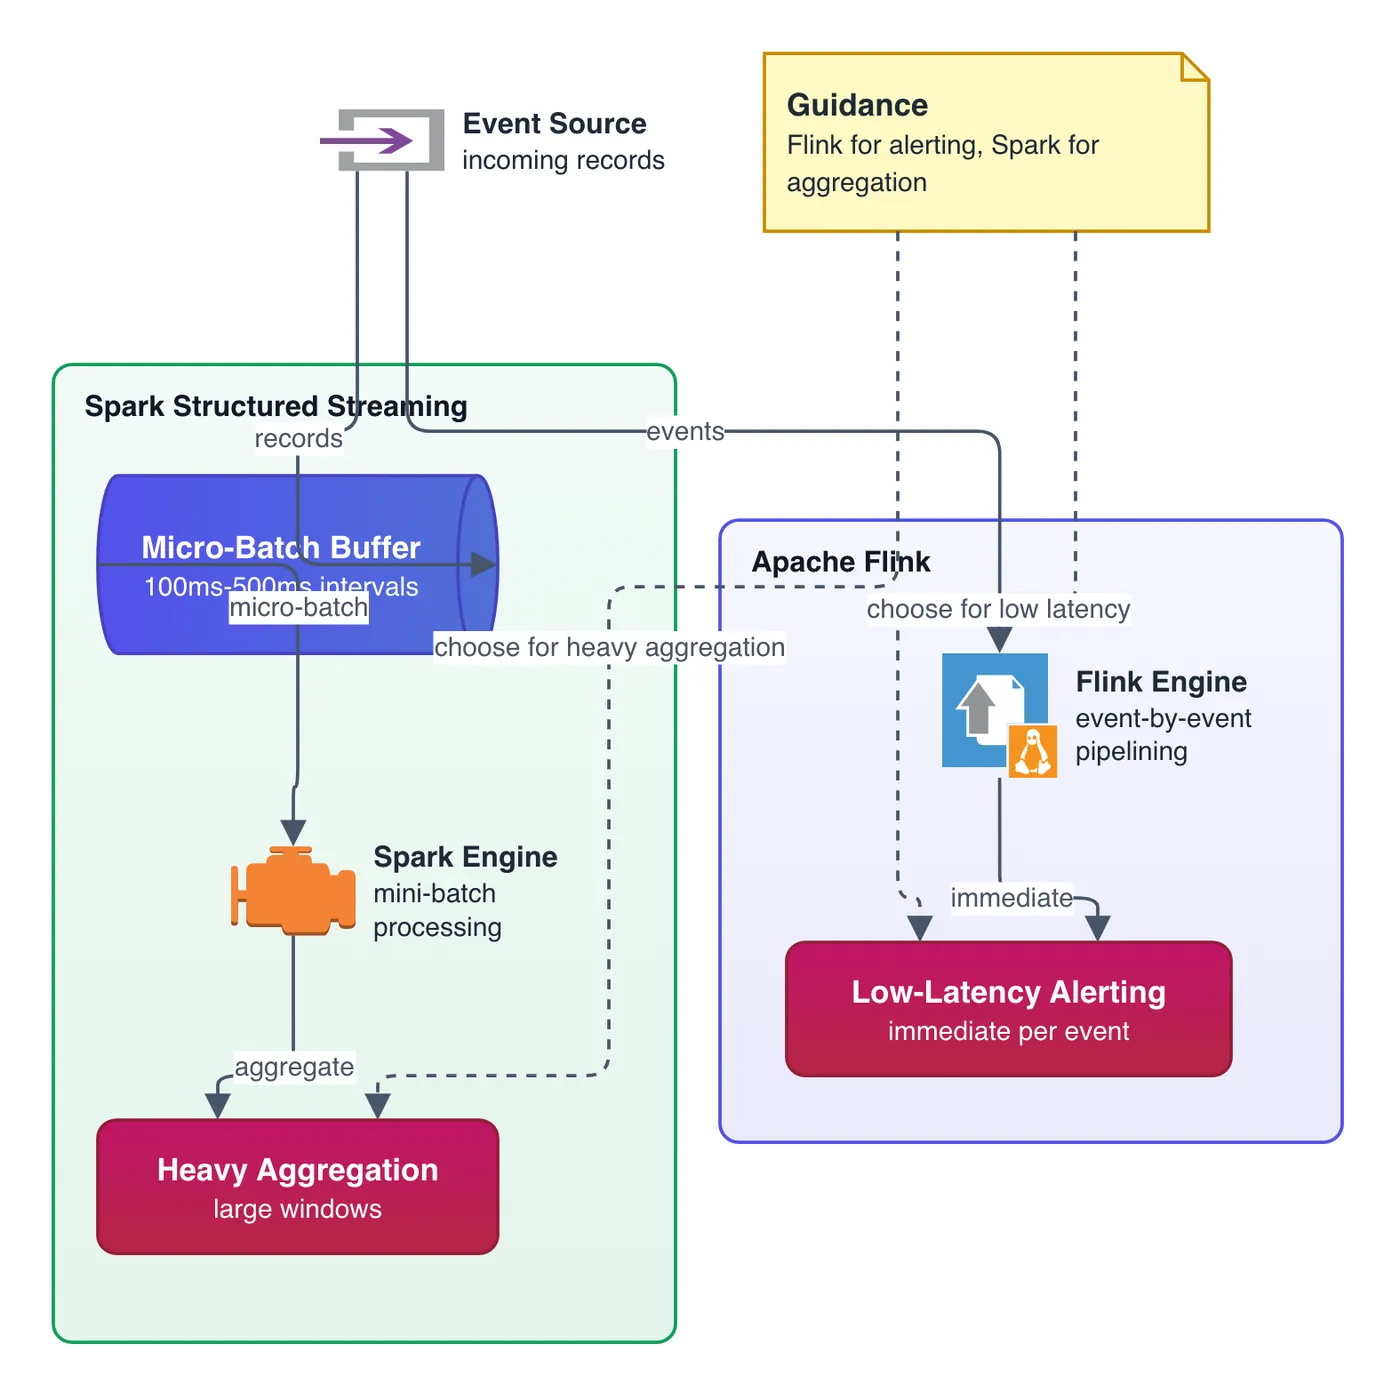
- Spark micro-batches buffer incoming records for 100ms-500ms intervals
- Flink native streaming processes every event immediately as it arrives
- Choose Flink for low-latency alerting; choose Spark for heavy aggregation
The takeaway
Don't pay the operational complexity of native streaming if 500ms batch windows solve your business problem.
- #DataEngineering
- #ApacheSpark
- #ApacheFlink
- #BigData
- #StreamProcessing
- #Kafka