Multimodal Document Ingestion for RAG
Data & AI Pipelines diagram · made in Skemio
What it shows
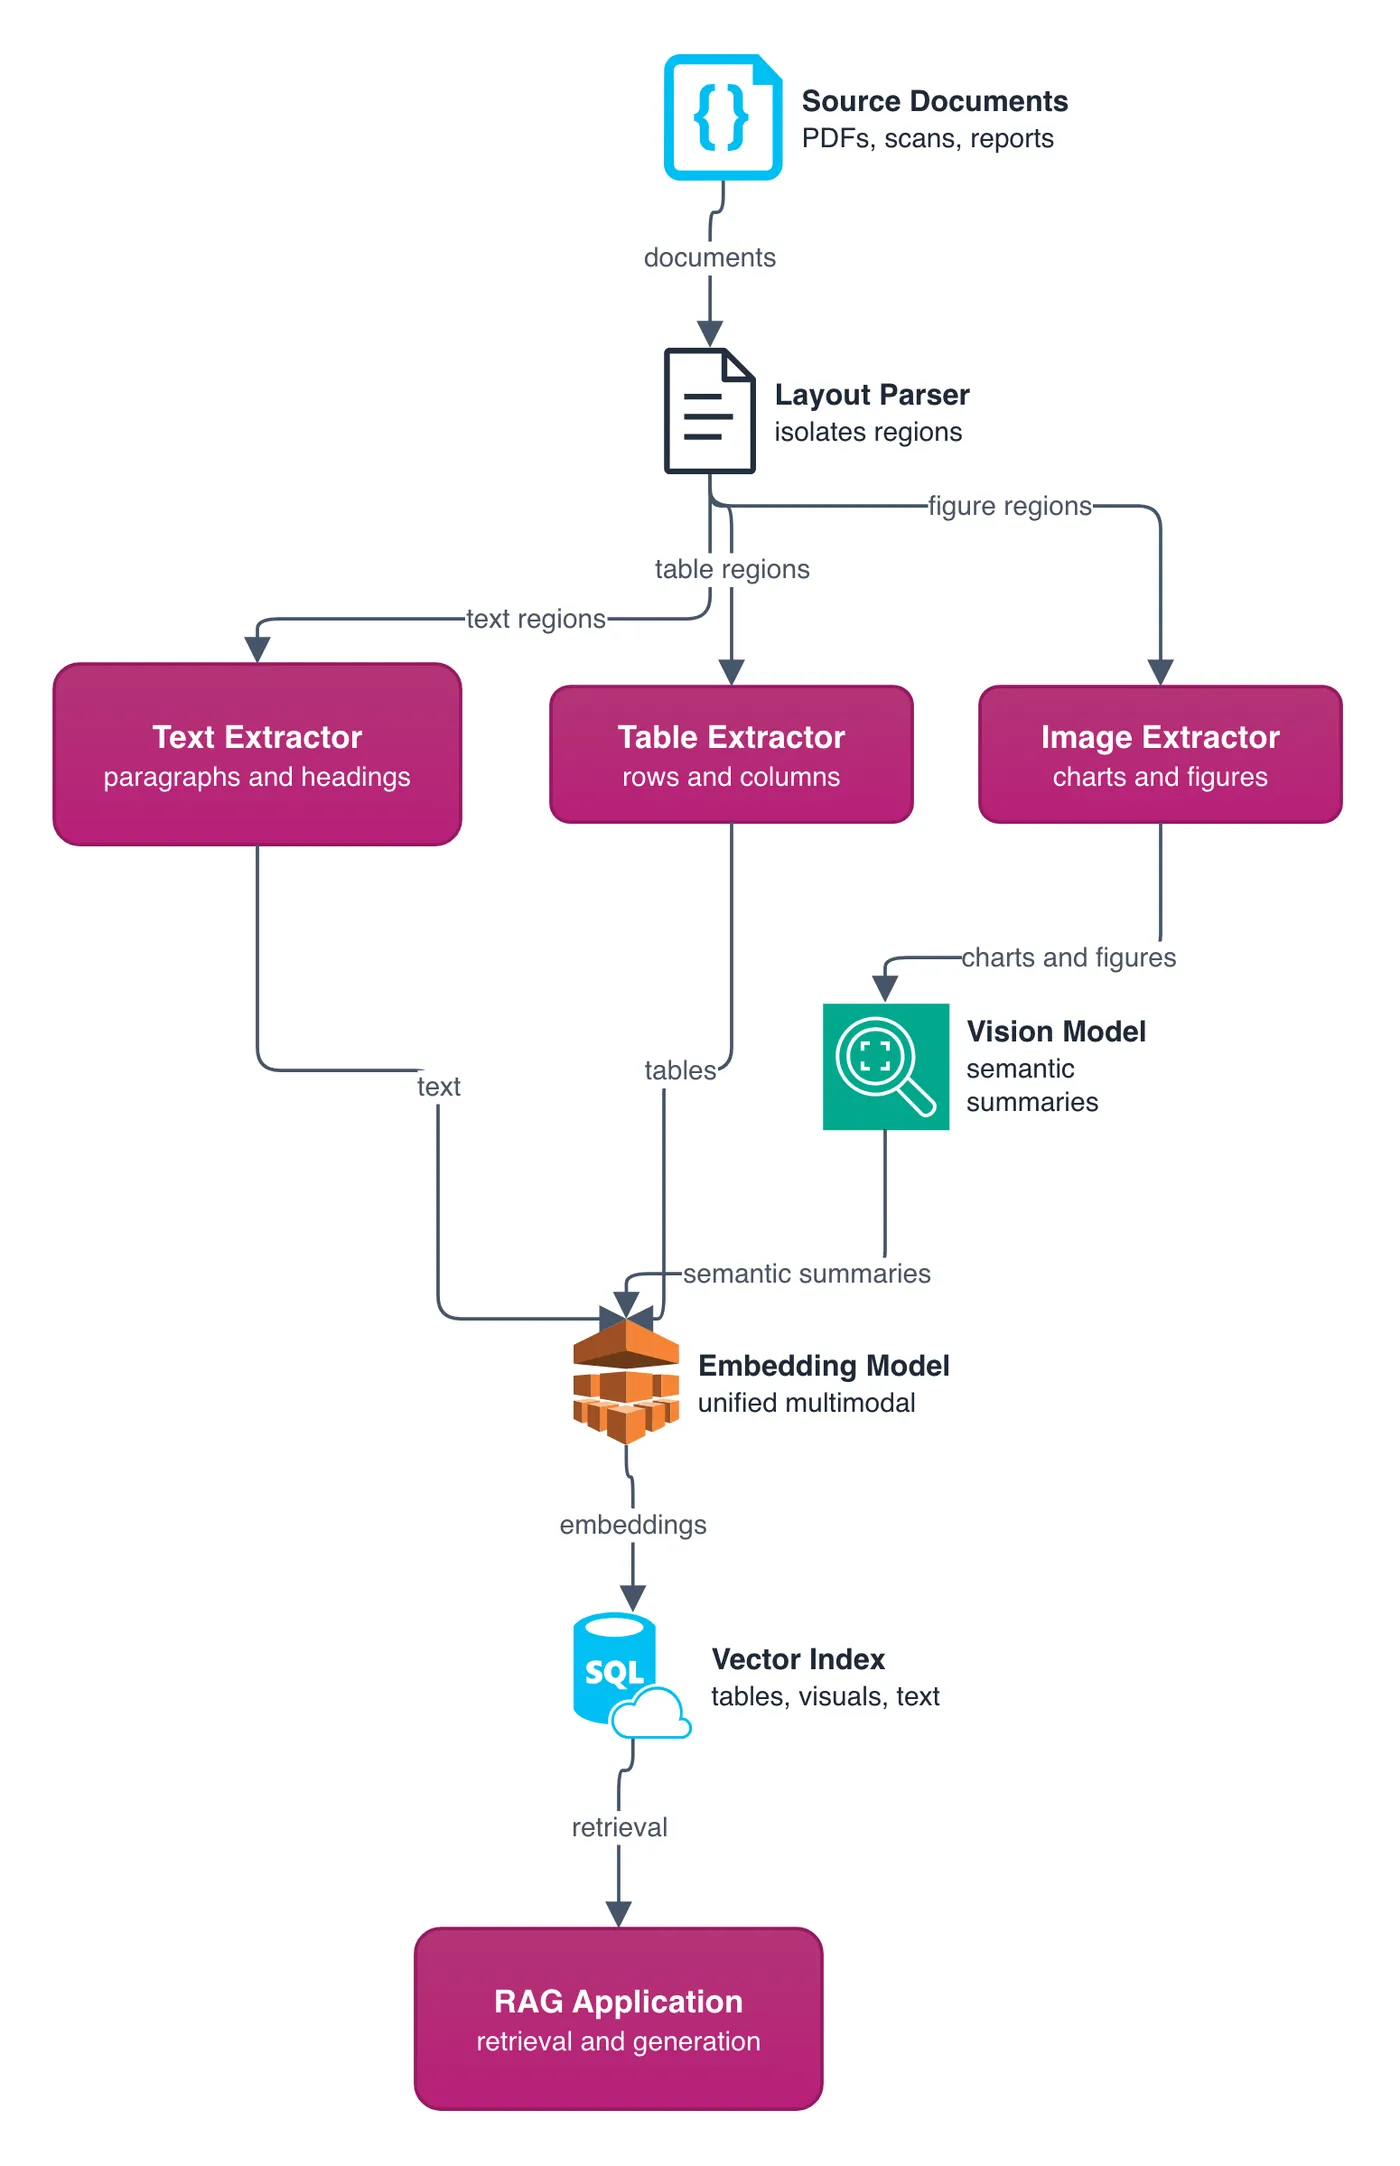
- Layout parsers isolate tables, text, and embedded diagrams accurately.
- Vision models generate rich semantic summaries of charts and figures.
- Unified multi-modal embeddings index tables and visuals alongside text.
The takeaway
Preserve document layout and use vision models so your RAG pipeline never loses visual context.
- #RAG
- #MachineLearning
- #VectorSearch
- #DataEngineering
- #GenAI
- #SystemDesign