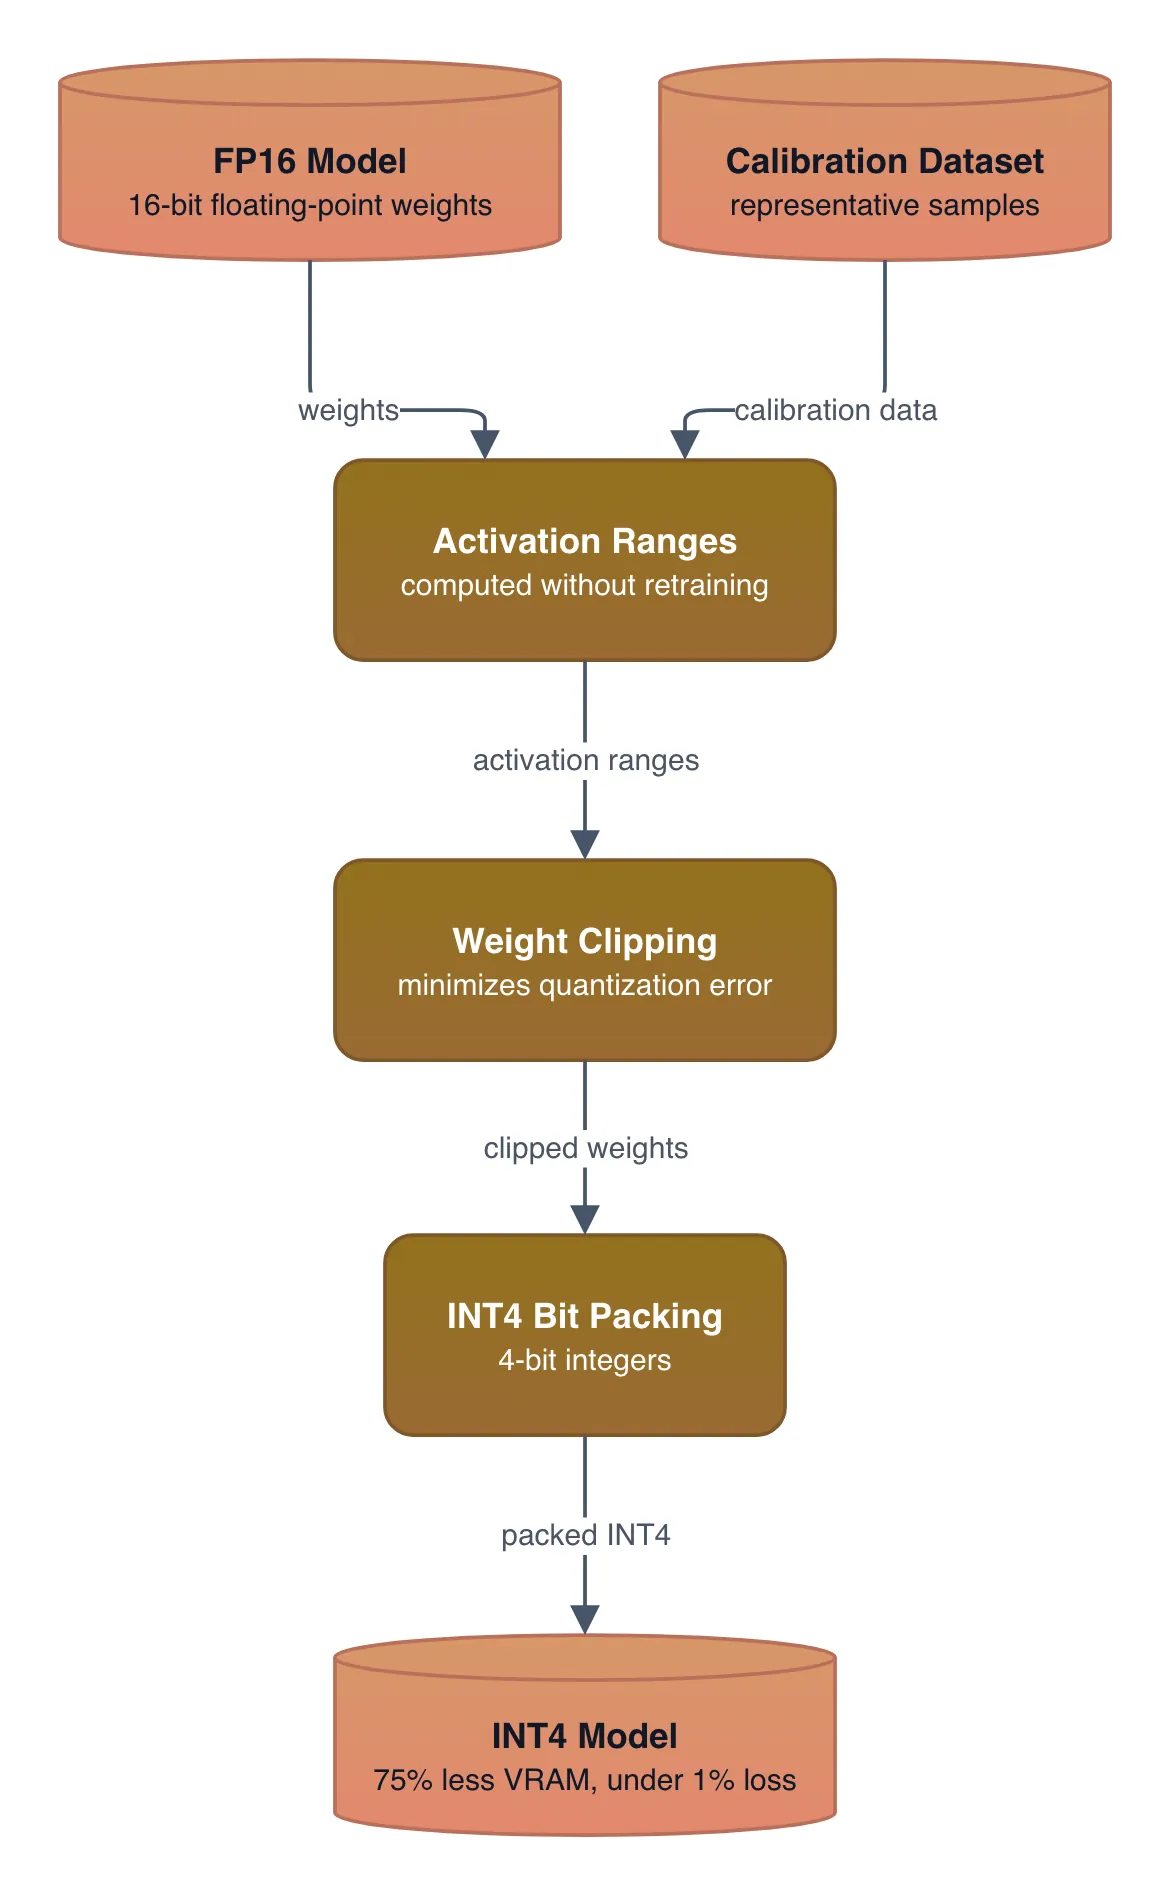
Post-Training Quantization Flow (FP16 to INT4)
Data & AI Pipelines diagram · made in Skemio
What it shows
- Calibration sets compute activation ranges without retraining the model.
- Weight clipping minimizes quantization error across critical layers.
- INT4 bit packing shrinks VRAM footprint by 75% with under 1% loss.
The takeaway
PTQ lets you run 70B parameter models on single GPU instances with near-lossless output quality.
- #Quantization
- #LLMOps
- #MachineLearning
- #DeepLearning
- #GPU
- #PyTorch