Real-Time Model Serving with Triton
Data & AI Pipelines diagram · made in Skemio
What it shows
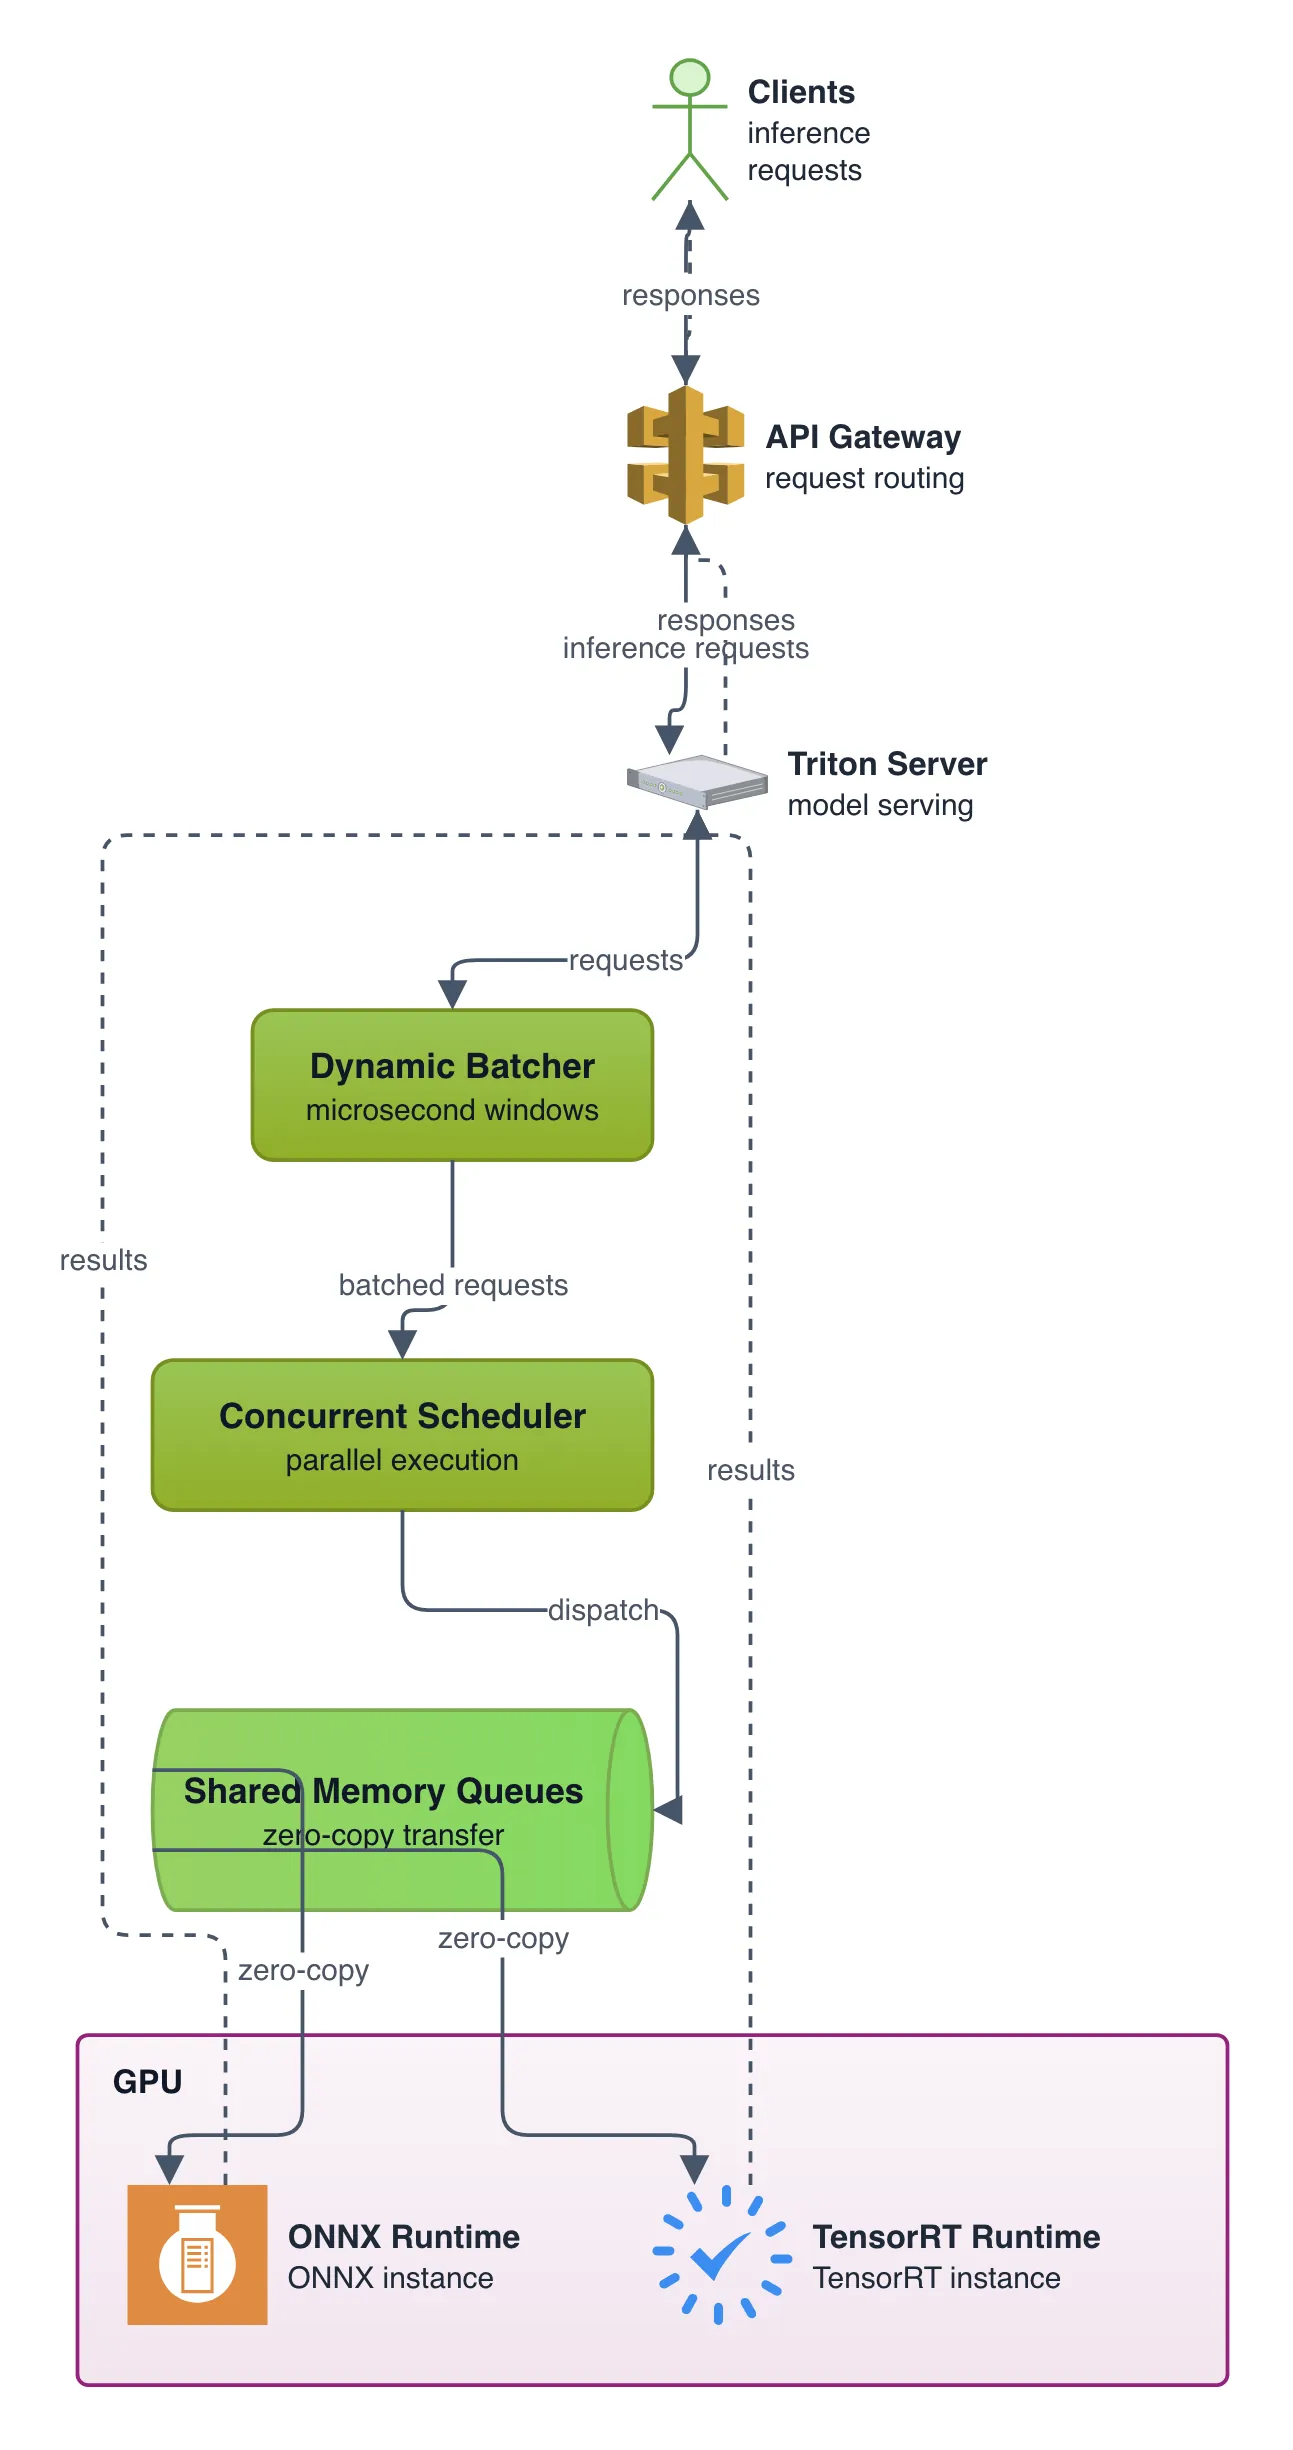
- Dynamic batching combines disparate requests within microsecond windows.
- Concurrent model execution serves ONNX and TensorRT instances in parallel.
- Shared memory queues eliminate serialization overhead between pipelines.
The takeaway
Triton maximizes GPU saturation by grouping concurrent user requests into dense computational batches.
- #ModelServing
- #Triton
- #GPUCompute
- #MachineLearning
- #AIInfrastructure