RLHF/DPO Human Feedback Pipeline
Data & AI Pipelines diagram · made in Skemio
What it shows
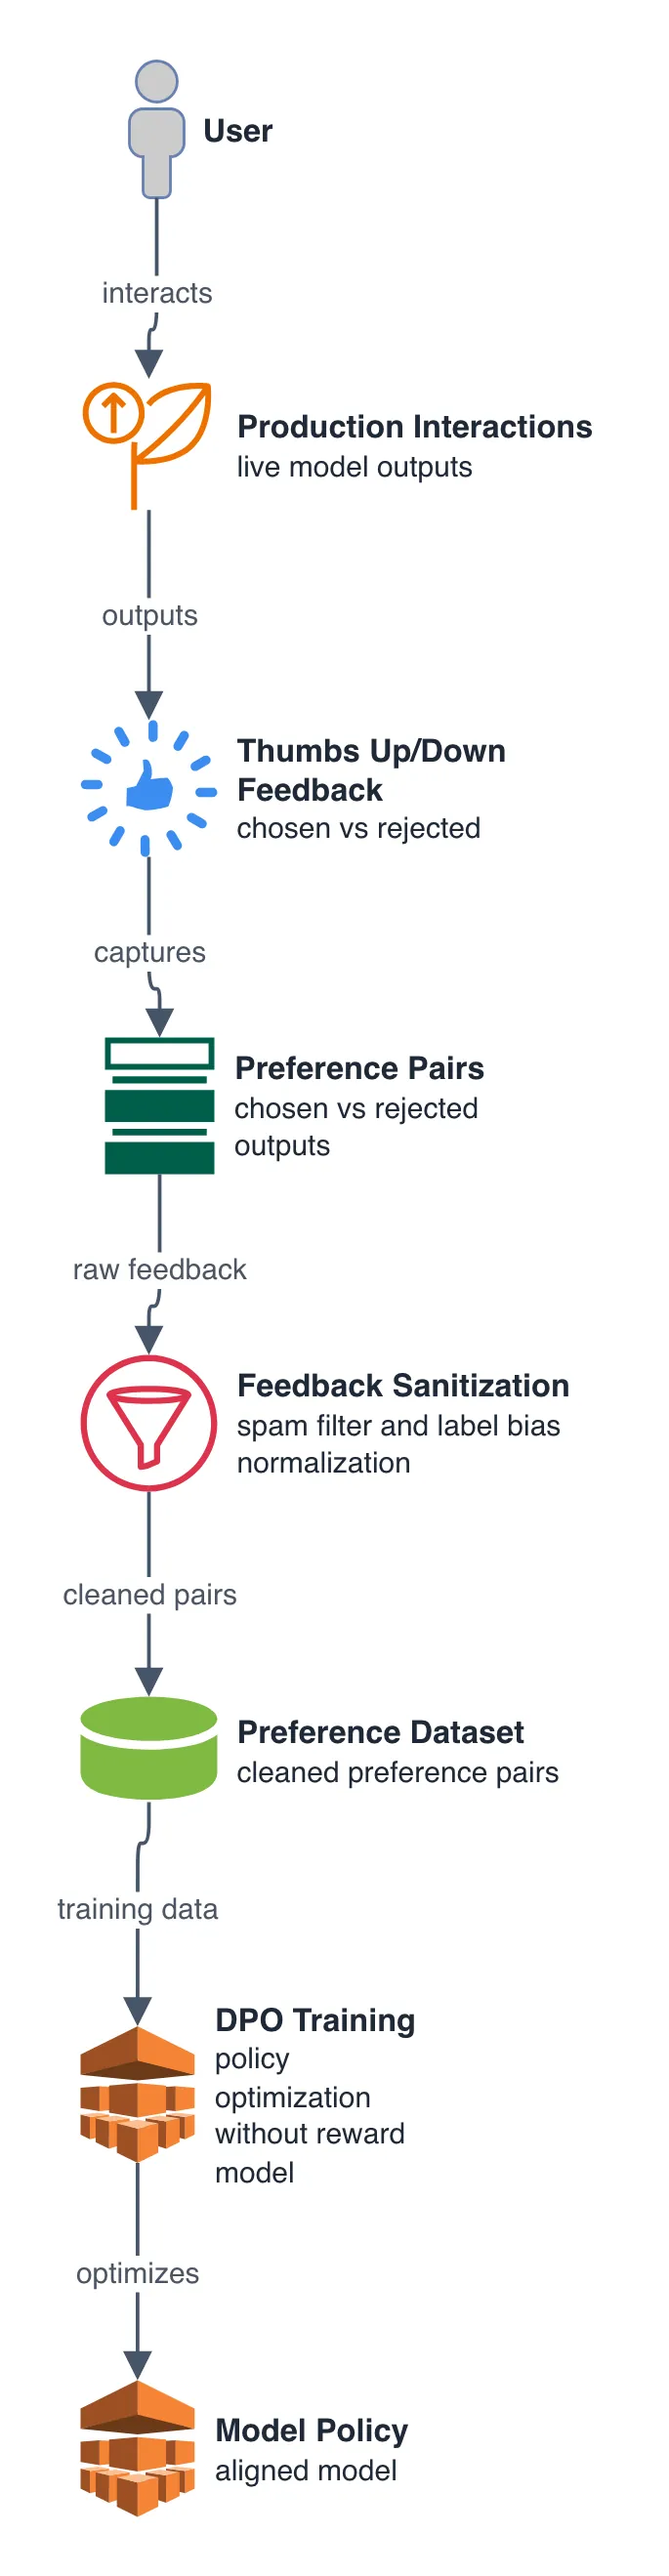
- Production interactions yield continuous pairs of chosen vs rejected outputs.
- Feedback sanitization filters spam and normalizes label bias automatically.
- Direct Preference Optimization trains model policy without a reward model.
The takeaway
Capture continuous thumbs-up rankings in production to iteratively align LLM behavior via DPO.
- #RLHF
- #DPO
- #LLMOps
- #MachineLearning
- #ArtificialIntelligence
- #DeepLearning